
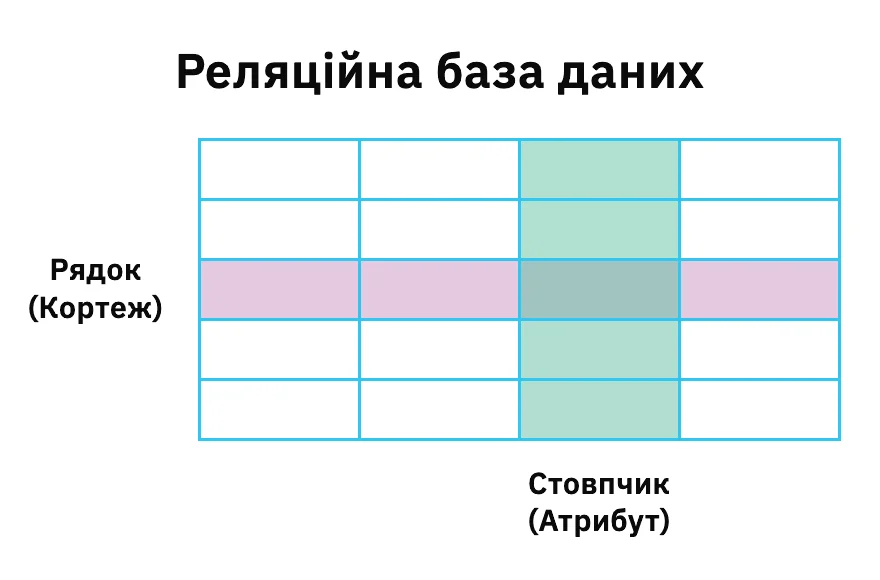
Представьте базу данных как огромную библиотеку, где каждая книга – это таблица, а страницы в ней наполнены строками, скрывающими целые истории о данных. Эти строки, которые мы часто называем просто "записями", действительно носят более точные имена в мире реляционных баз данных. Они являются основой всего, позволяя нам организовывать информацию от простых списков контактов до сложных финансовых систем. Разберемся, почему эти элементы так важны, и как они эволюционировали со временем, опираясь на классические концепции, уходящие корнями в 1970-е годы.
Когда мы говорим о строках в таблицах базы данных, первое, что приходит на ум – это их роль в качестве контейнеров для данных. Каждая такая строка собирает вместе связанные значения, как мозаика, формирующая полную картину. В реляционных моделях, которые доминируют в современных системах типа MySQL или PostgreSQL, строка не просто линия текста – это структурированный элемент, обеспечивающий целостность и быстрый доступ. А теперь погрузимся глубже в терминологию, потому что здесь кроется суть: строки часто называют кортежами или записями, и каждый термин несет свой оттенок значение.
Основные термины для строк в базах данных
В реляционных базах данных строка – не случайный набор символов, а четко определенная структура. Согласно классической теории Эдгара Кодда, разработанной еще в 1970 году, строка является кортежем, то есть упорядоченным множеством значений, где каждое значение соответствует определенному атрибуту. Это как строка в книге, где каждое слово стоит на своем месте, создавая смысл. В повседневной практике разработчиков этот термин упрощается к “записи”, что делает ее более доступной для новичков.
Кортеж – это математический термин, заимствованный из теории множеств, где он обозначает последовательность элементов. В контексте баз данных, как отмечает Википедия, кортеж представляет один элемент данных в таблице с неявной структурой. Например, в таблице "Клиенты" кортеж может содержать имя, адрес и номер телефона одного человека. Это делает базу данных гибкой, позволяя миллионам таких кортежей сосуществовать без путаницы. А вот в нереляционных системах, как MongoDB, аналогом может быть документ, но мы сосредоточимся на реляционном подходе, потому что именно он доминирует в 80% корпоративных приложений по состоянию на 2025 год.
Запись – еще один синоним, часто используемый в практических руководствах, например, в документации Microsoft Access. Он подчеркивает практический аспект: строка как единица хранимой и извлекаемой информации. Этот термин особенно удобен для начинающих, потому что напоминает о ежедневном использовании, как запись в дневнике. Однако, в строгих академических кругах предпочитают "кортеж", чтобы подчеркнуть математическую основу. Оба термина точны, но выбор зависит от контекста – в SQL-запросах вы увидите “row” или “record”, переводимый как строку или запись.
Исторический контекст терминологии
Эволюция этих заглавий началась с работ Эдгара Кодда, который в собственной статье для IBM в 1970 году ввел понятие реляционной модели. Там строчки назывались кортежами, вдохновленными математикой, чтобы избежать неоднозначности. С годами, когда базы данных стали массовыми, термин "запись" приобрел популярность в коммерческих системах, как Oracle или SQL Server. По состоянию на 2025 год, по данным Stack Overflow Survey, более 60% разработчиков используют "row" в коде, но в украинской литературе, например, в руководствах от Microsoft, преобладает "строка" или "запись".
Интересно, как культурные аспекты влияют на терминологию. В англоязычном мире tuple происходит от латинского, напоминая о последовательностях, тогда как в украинском языке кортеж звучит элегантно, будто процессия данных. Это не просто слова – они формируют наше восприятие баз данных как организованного хаоса, где каждая строчка играет роль в большой симфонии информации.
Структура строк в реляционных таблицах
Каждая строка в таблице базы данных – это комбинация полей или столбцов, заполненных данными. Представьте таблицу как сетку, где горизонтальные линии – это строки, а вертикальные – атрибуты. К примеру, в базе данных для онлайн-магазина строка может выглядеть так: ID товара, название, цена, количество. Каждая строка уникальна благодаря ключам, предотвращающим дублирование, будто блюстители порядка.
В SQL, языке запросов, строки извлекаются командами типа SELECT, где вы указываете, какие именно кортежи нужны. Это делает работу с данными быстрой – современные системы, как PostgreSQL, обрабатывают миллионы строк в секунды. Но структура не статическая: нормализация, процесс распределения данных по таблицам, обеспечивает, чтоб строки не повторяли информацию, уменьшая ошибки. По данным Gartner на 2025 год, неэффективная структура приводит к 30% потерям производительности в проектах.
Сравним с нереляционными моделями. В NoSQL базах, как Cassandra, строки могут быть более гибкими, без фиксированной схемы, но в реляционных все четко: строка всегда соответствует схеме таблицы. Это как разница между жестким расписанием и свободным днем – оба имеют преимущества, но реляционный подход преобладает в банковских системах из-за надежности.
Примеры строк в популярных СУБД
Возьмем MySQL: здесь строка – это запись в таблице, созданная INSERT-запросом. Представьте таблицу "Пользователи" со строками, где каждый содержит логин, пароль (закрытый, конечно) и email. В PostgreSQL строки поддерживают расширенные типы данных, как JSON, делая их универсальными. А в Microsoft Access, ориентированном на новичков, строки визуализируются в интерфейсе, словно листы в блокноте.
Вот таблица для иллюстрации структуры строк в простой базе данных о книгах:
| ID | Название | Автор | Год издания |
|---|---|---|---|
| 1 | 1984 | Джордж Оруэлл | 1949 |
| 2 | Гарри Поттер и философский камень | Дж. К. Роллинг | 1997 |
| 3 | Мастер и Маргарита | Михаил Булгаков | 1967 |
Эта таблица показывает, как строки организуют данные. Источник: вдохновлен примерами из документации MySQL и сайта Microsoft. После такой визуализации становится понятно, почему строки – сердце базы данных: они делают информацию доступной и управляемой.
Роль ключей и уникальности в строках
Без ключей строки в таблицах базы данных были бы хаосом, словно толпа без имен. Первичный ключ – это уникальный идентификатор для каждой строчки, часто автоинкрементное число. В теории Кодда ключ обеспечивает, чтобы ни один кортеж не дублировался, поддерживая цельность. Внешние ключи связывают строки между таблицами, создавая отношения, словно мосты между островами данных.
В практике это выглядит так: в таблице "Заказ" внешний ключ ссылается на строку в "Клиенты", предотвращая ошибки. По состоянию на 2025 год, по данным DB-Engines, системы с сильными ключевыми механизмами как Oracle лидируют в enterprise-секторе. Без этого строки могли бы умножаться как кролики, приводя к ошибкам в отчетах.
А теперь об ошибках: новички часто игнорируют ключи, создавая дубликаты. Это как забыть пронумеровать страницы в книге – все перемешивается. В больших проектах ключи оптимизируют запросы, делая поиск молниеносным.
Типичные ошибки при работе со строками в базах данных
- 🛑 Игнорирование уникальности: Многие добавляют строки без проверки на дубликаты, что приводит к "грязным" данным и ошибкам в аналитике. К примеру, две одинаковые записи клиента могут удвоить продажи в отчетах.
- 🚫 Неправильная нормализация: Оставляя лишние данные в одной строке, вы создаете аномалии – изменение в одном месте не распространяется на все. Это классическая ловушка для начинающих в SQL.
- 🔍 Плохой выбор типов данных: Если поле даты заполняется текстом, строка становится неэффективной для запросов. Всегда проверяйте схему перед вставкой.
- ⚠️ Отсутствие индексов: Без них поиск по строкам замедляется, словно искать иглу в стоге сена. В 2025 году инструменты типа EXPLAIN в MySQL помогают избежать этого.
- 💥 Игнорирование ограничений: Позволяя NULL в ключевых полях, вы рискуете целостностью – строка может стать "призрачной", без полных данных.
Эти ошибки – не редкость, но их легко избежать с практикой. Они напоминают, как важно относиться к строкам как к живым элементам, нуждающимся в уходе.
Практические советы по работе со строками
Чтобы эффективно управлять строками, начинайте с четкой схемы таблицы. Используйте инструменты типа ER-диаграмм для визуализации, где каждая строка будет иметь свое место. В коде SQL всегда добавляйте WHERE для точного выбора строк, избегая полных сканов. Для больших баз данных, как в e-commerce, партицирование таблиц распределяет строки, ускоряя доступ.
Новичкам советую экспериментировать с бесплатными инструментами, как SQLite, где строчки создаются просто. Продвинутые пользователи могут погрузиться в оптимизацию, используя VIEW для виртуальных строчек. В 2025 году AI-инструменты, как в Google Cloud, даже генерируют запросы для строк автоматически, делая процесс веселым.
Будущее строк в базах данных
С появлением облачных технологий строки становятся распределенными, как у Amazon DynamoDB, где они реплицируются глобально. Это изменяет игру, делая данные устойчивыми к сбоям. Представьте строки, которые мигрируют между серверами, как птицы в стае. По прогнозам IDC на 2025 год, объем данных удвоится, поэтому понимание строк как кортежей или записей станет ключом к успеху.
Напоследок, строчки – это не просто линии в таблице, а фундамент цифрового мира. Они эволюционируют, адаптируясь к новым вызовам, и каждый работающий с ними становится частью этой истории. То ли в маленьком проекте, то ли в гигантской системе, строчки держат все вместе, словно невидимые нити.